Week 4 数据可视化
本章导读 时长:3 节课,每节 45 分钟 数据:
data/05-eda-viz/diamonds.csv、data/05-eda-viz/midwest.csv、data/05-eda-viz/energy_dataset.csv、data/04-cleaning/Life_Expectancy_Data.csv参考脚本:scripts/04-viz/下 15 个文件,与正文代码块一一对应。 你将学到:先判断变量类型,再选直方图、箱线图、柱状图或折线图;用 pandas 和 matplotlib 出图,并用标题、轴标签、图例或样本量把图讲清楚 本周产出:projects/<姓名>/下的 6 张图,覆盖单变量分布、分类对比、时间趋势和组合图
本周只做一件事:用图回答一个具体问题,而不是把数据“画出来就算完”。每张图都要能回答“我想比较什么、用了多少样本、读出了什么结论”。
flowchart LR
    A[提出问题与变量类型] --> B[整理数据与样本量]
    B --> C[选图:直方图 / 箱线图 / 柱状图 / 折线图]
    C --> D[pandas 或 matplotlib 出图]
    D --> E[加标题、轴标签、图例或样本量]
    E --> F[读图写出结论]
pandas 和 matplotlib 都是第三方库。运行前先 pip install pandas matplotlib,代码开头写 import pandas as pd 和 import matplotlib.pyplot as plt。本章不引入 seaborn。
安全规则(Week 4 全周不变):
data/下的原始文件只读:不删除、不覆盖、不原地改写。- 图全部写入
projects/<姓名>/,不写回data/。 - 每张图必须有标题、轴标签、图例或样本量,三者缺一不可。
- 先想清楚变量是数值型还是分类型,再决定用哪种图;不盲信 DSH 直接生成的图。
1. 第 1 节课 单变量分布与分类对比(45 分钟)
| 时间 | 环节 | 内容 |
|---|---|---|
| 8 分钟 | 演示 | 讲数值单变量用直方图/箱线图,分类对比用 groupby().plot.bar() |
| 30 分钟 | 练习 | 学生画 diamonds 价格分布、midwest 各州人口柱状图,并补齐标签 |
| 7 分钟 | 复盘 | 核对样本量:diamonds 53940 行、price 中位数 2401、midwest 人口最多州 IL |
1.1 问题
diamonds.csv的price分布长什么样,中心在哪里,是右偏还是左偏?- 不同
cut(切工)的价格中位数差多少,箱线图怎么看? midwest.csv里 5 个州各自的总人口是多少,柱状图怎么读?
1.2 概念
- 变量类型决定图:一个数值变量看分布用直方图或箱线图;一个分类变量对比数值用柱状图。
- 直方图把数值切成等宽区间(
bins),数每个区间有多少行;bins太少会掩盖形状,太多会放大噪声。 - 箱线图用五数概括:最小值、Q1、中位数、Q3、最大值,箱体外的点是离群点。
- 分类对比先
groupby(...).sum()或.mean(),再用plot.bar();直接画原始行没有意义。 plt.subplots()返回画布fig和坐标轴ax,在ax上画图比全局plt.hist()更可控。
1.3 最小代码
先画钻石价格直方图:
import matplotlib.pyplot as plt
import pandas as pd

diamonds = pd.read_csv('data/05-eda-viz/diamonds.csv')

diamonds['price'].plot.hist(bins=50, figsize=(8, 4))
plt.title('Price distribution')
plt.xlabel('price')
plt.ylabel('count')
plt.show()
脚本:01-diamonds-histogram.py | 数据:diamonds.csv
再画价格箱线图:
import matplotlib.pyplot as plt
import pandas as pd

diamonds = pd.read_csv('data/05-eda-viz/diamonds.csv')

diamonds['price'].plot.box(figsize=(5, 4))
plt.title('Price boxplot')
plt.show()
脚本:02-diamonds-boxplot.py | 数据:diamonds.csv
最后画分类对比柱状图:
import matplotlib.pyplot as plt
import pandas as pd

midwest = pd.read_csv('data/05-eda-viz/midwest.csv')

midwest.groupby('state')['poptotal'].sum().plot.bar(figsize=(8, 4))
plt.title('Total population by state')
plt.xlabel('state')
plt.ylabel('population')
plt.show()
脚本:03-midwest-bar.py | 数据:midwest.csv
这三段只出图,不打印文本。记住顺序:先选图,再补标题、轴标签和样本量。
1.4 自己试
- 读入
diamonds.csv,输出shape和price的describe(),核对均值 3932.80、中位数 2401.00。 - 把直方图
bins从 50 改成 10 和 100,观察形状怎么变。 - 用
diamonds['price'].plot.box()画箱线图,指出箱体上下边对应哪两个分位数。 - 读入
midwest.csv,用groupby('state')['poptotal'].sum().plot.bar()画柱状图,说明哪州人口最多。 - 给柱状图补上标题、轴标签和样本量。
1.5 应用到数据
第 1 步:diamonds 单变量分布,先打印数字再出图。
import pandas as pd

diamonds = pd.read_csv('data/05-eda-viz/diamonds.csv')

print('shape:', diamonds.shape)
print('price 五数概括:')
print(diamonds['price'].describe().round(2).to_string())
print()
print('cut 计数:')
print(diamonds['cut'].value_counts().to_string())
print()
print('按 cut 分组的 price 均值与中位数:')
print(diamonds.groupby('cut')['price'].agg(['count', 'mean', 'median']).round(2).to_string())
脚本:04-diamonds-summary.py | 数据:diamonds.csv
实际输出:
shape: (53940, 10)
price 五数概括:
count    53940.00
mean      3932.80
std       3989.44
min        326.00
25%        950.00
50%       2401.00
75%       5324.25
max      18823.00

cut 计数:
cut
Ideal        21551
Premium      13791
Very Good    12082
Good          4906
Fair          1610

按 cut 分组的 price 均值与中位数:
           count     mean  median
cut
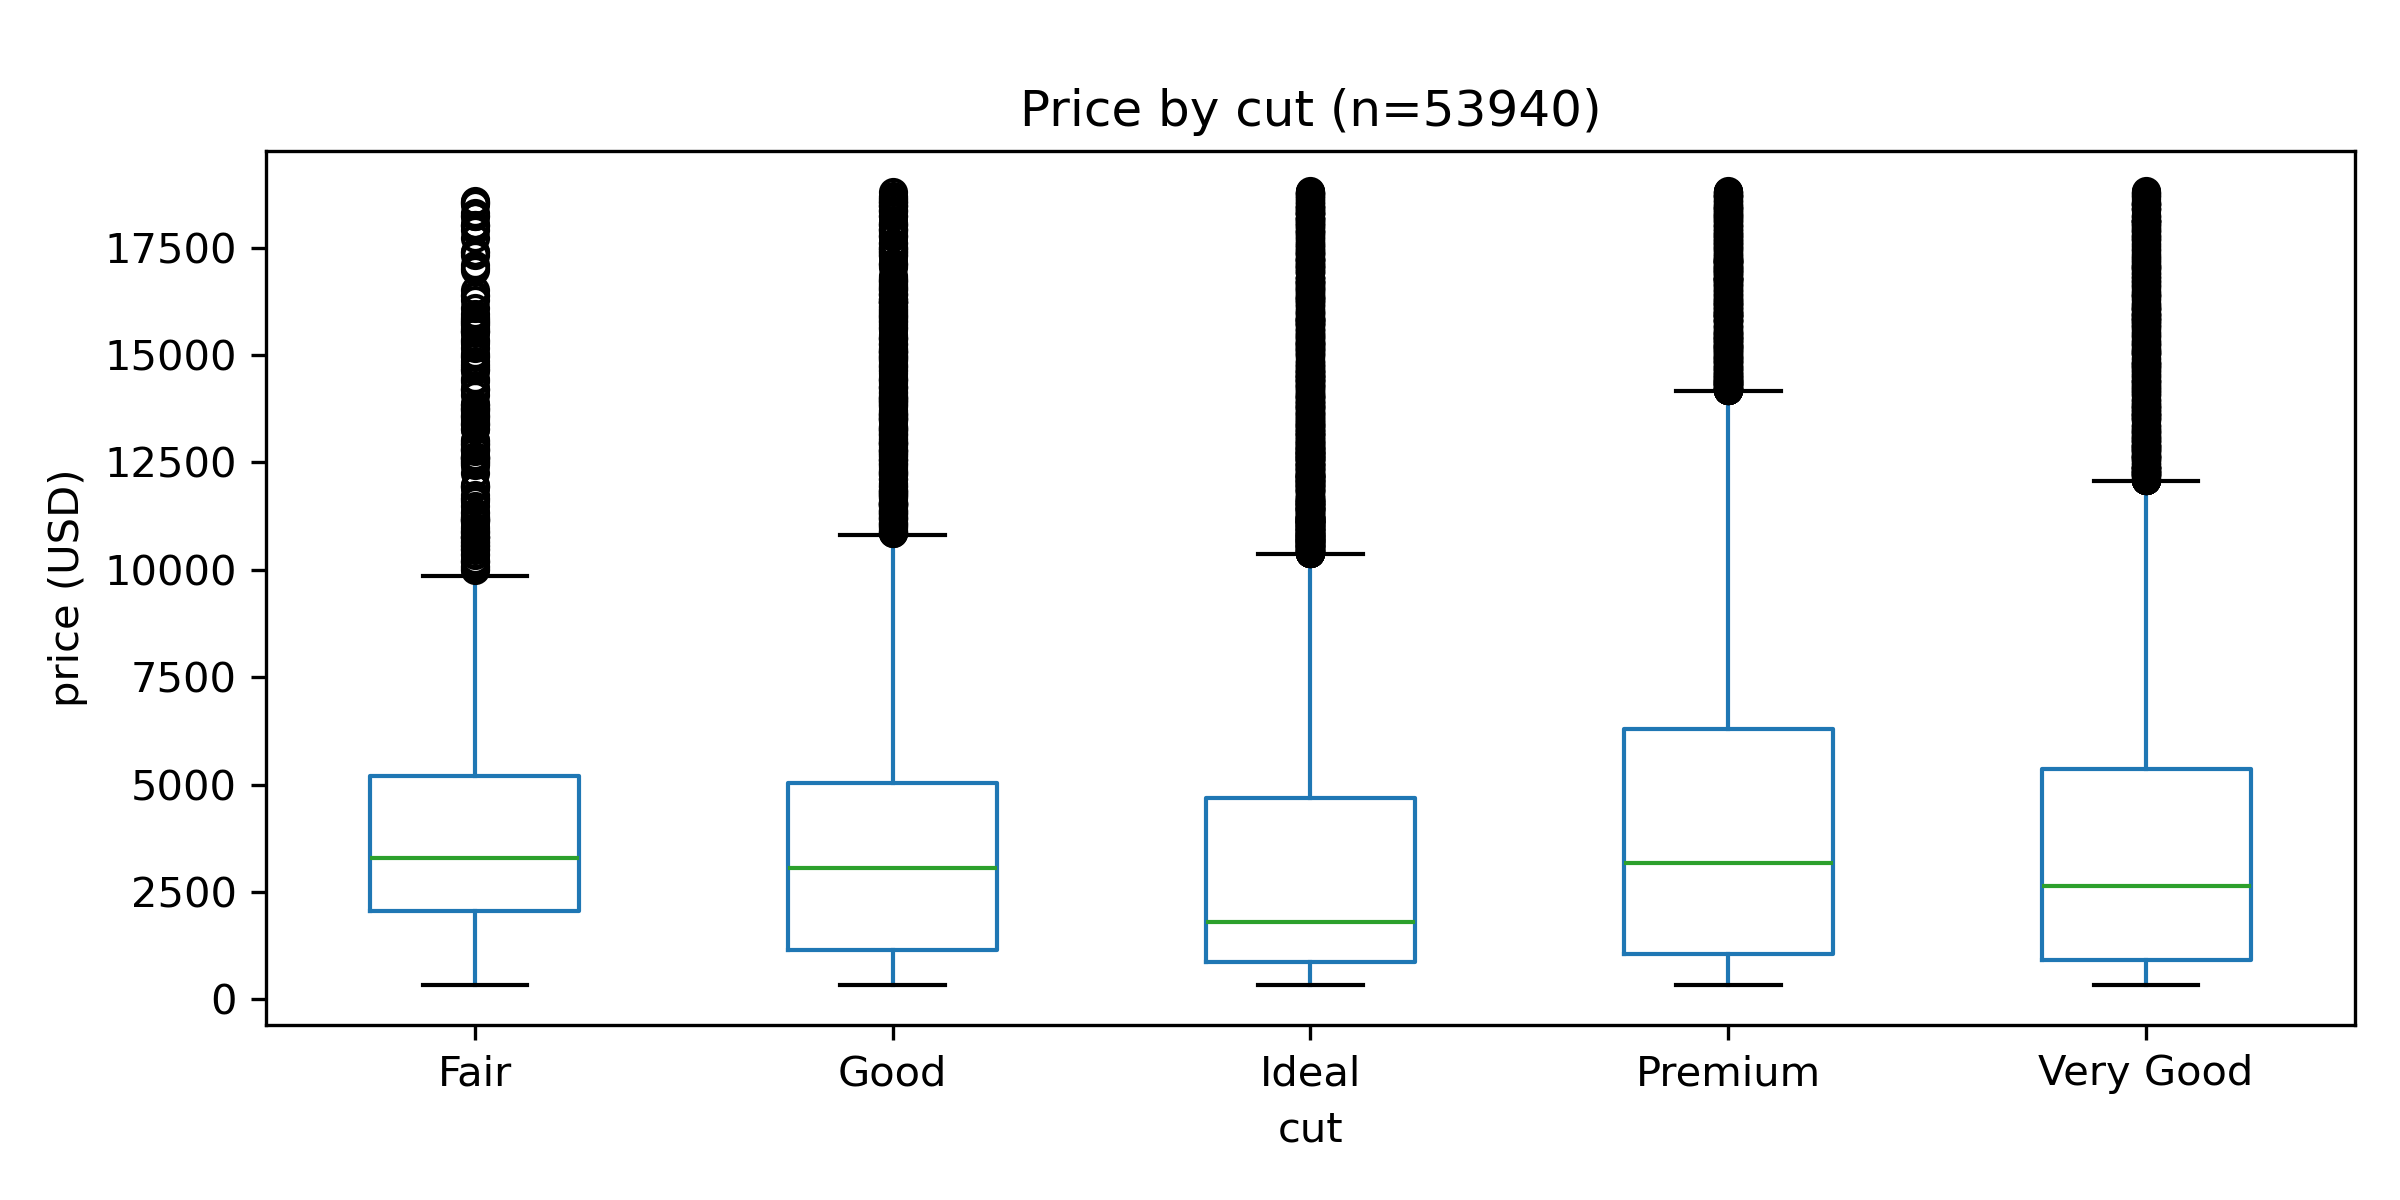
Fair        1610  4358.76  3282.0
Good        4906  3928.86  3050.5
Ideal      21551  3457.54  1810.0
Premium    13791  4584.26  3185.0
Very Good  12082  3981.76  2648.0
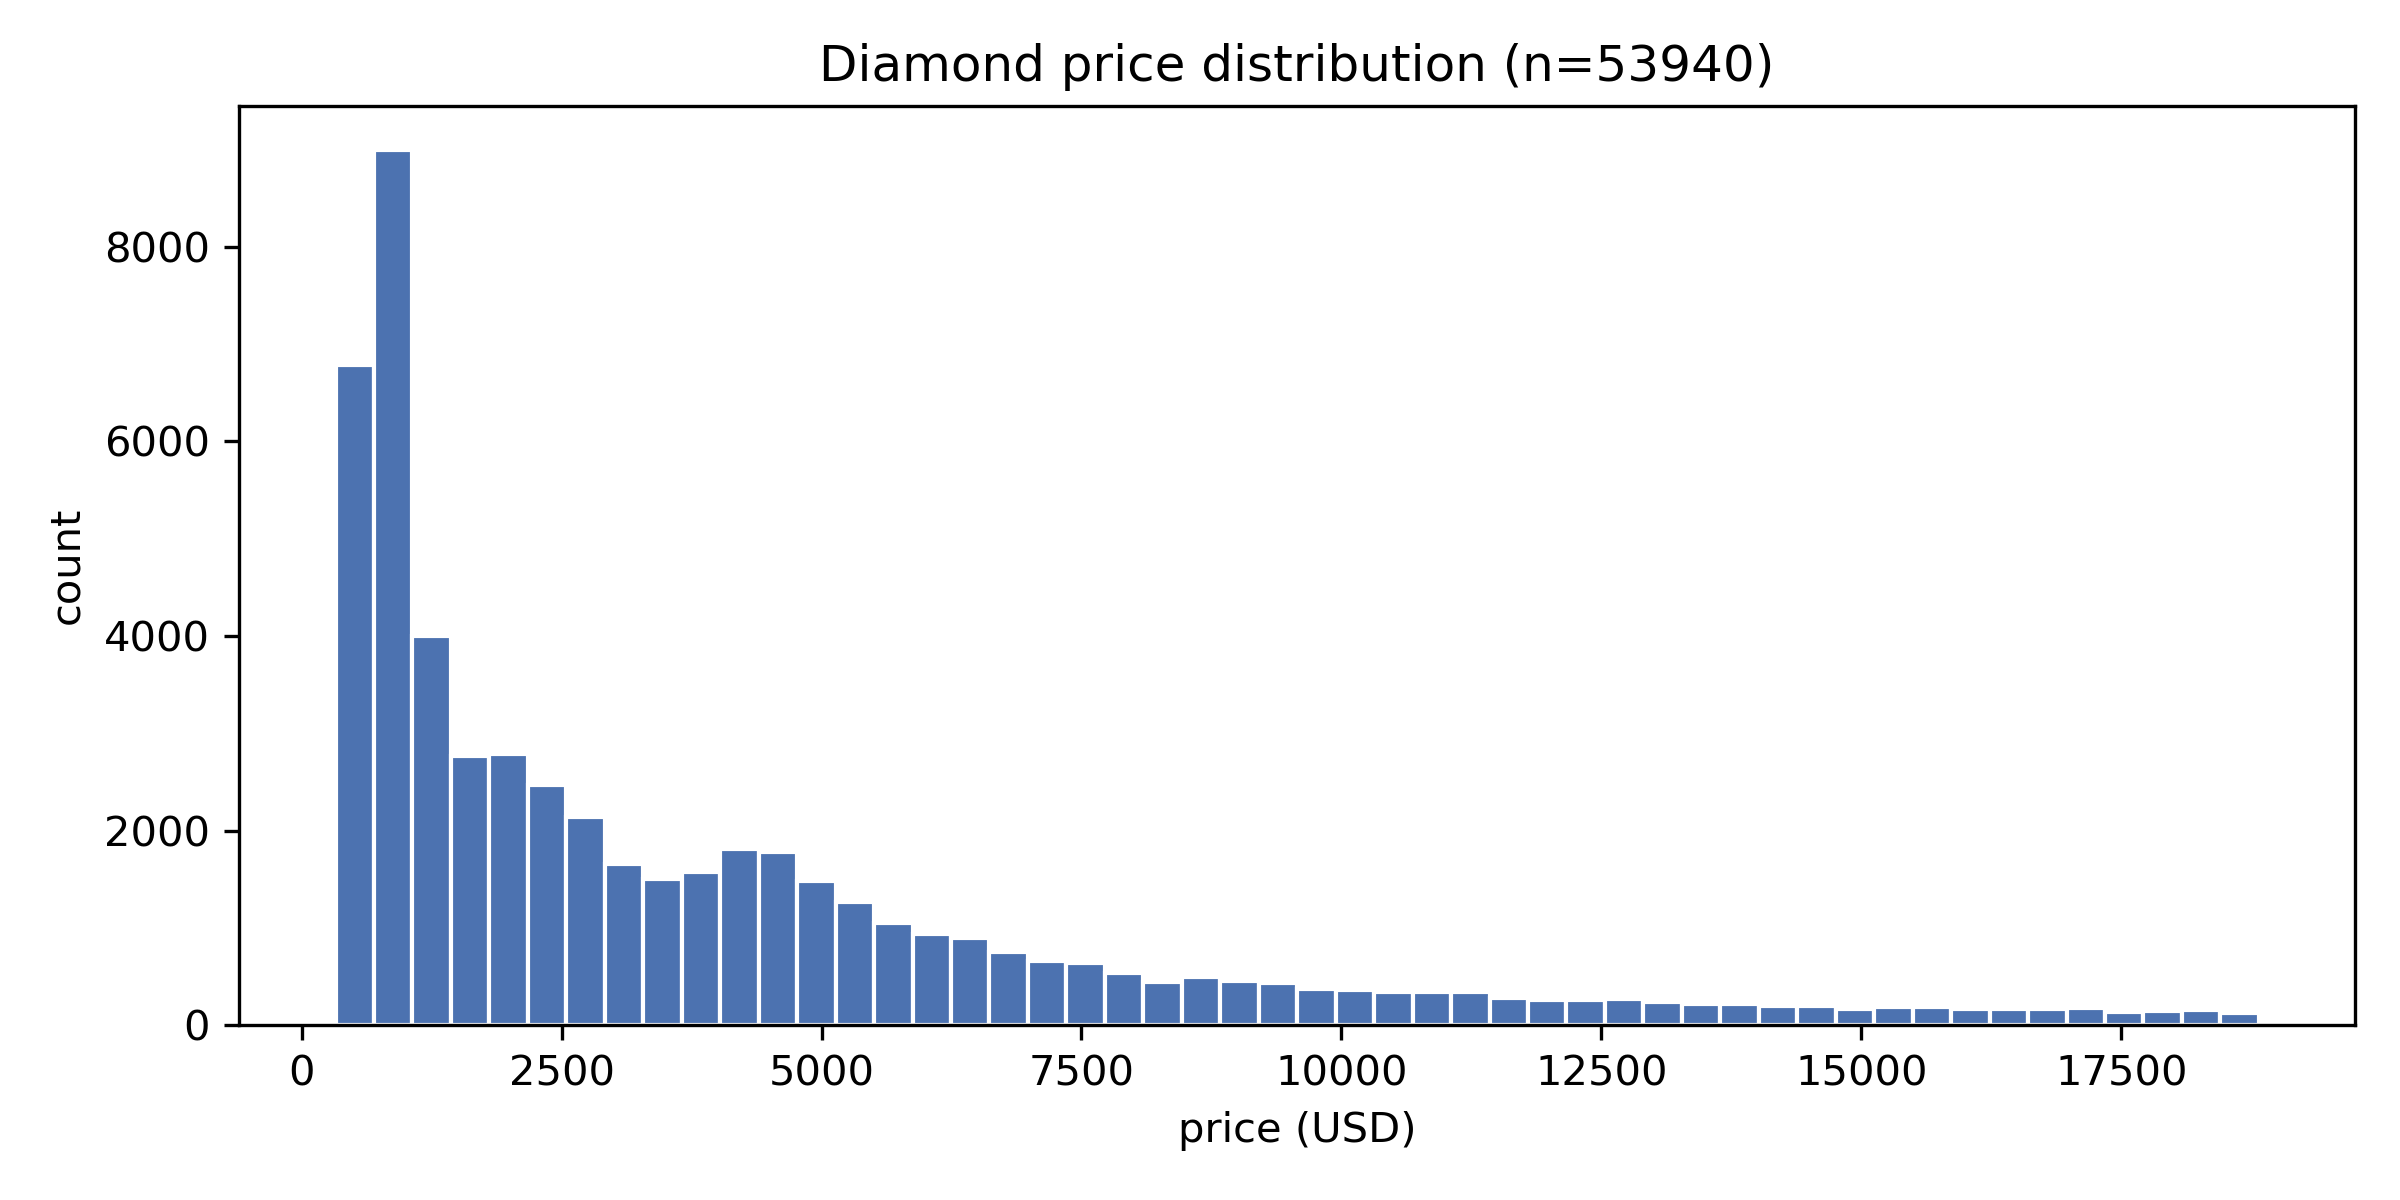
读法:53940 颗钻石里,price 均值 3932.80 明显高于中位数 2401.00,是右偏分布;最贵的 18823,最便宜的 326。cut 计数里 Ideal 最多(21551),Fair 最少(1610)。
第 2 步:diamonds 出图,示例写入 projects/demo/04-viz,作业换成 projects/<姓名>/。
import os
import matplotlib.pyplot as plt
import pandas as pd

diamonds = pd.read_csv('data/05-eda-viz/diamonds.csv')
out_dir = 'projects/demo/04-viz'
os.makedirs(out_dir, exist_ok=True)

# 直方图:标题带样本量
fig, ax = plt.subplots(figsize=(8, 4))
ax.hist(diamonds['price'], bins=50, color='#4c72b0', edgecolor='white')
ax.set_title(f"Diamond price distribution (n={len(diamonds)})")
ax.set_xlabel('price (USD)')
ax.set_ylabel('count')
fig.tight_layout()
fig.savefig(os.path.join(out_dir, 'diamonds_price_hist.png'), dpi=300)
plt.close(fig)

# 箱线图:按 cut 分类对比
fig, ax = plt.subplots(figsize=(8, 4))
diamonds.boxplot(column='price', by='cut', ax=ax, grid=False)
ax.set_title(f'Price by cut (n={len(diamonds)})')
ax.set_xlabel('cut')
ax.set_ylabel('price (USD)')
fig.suptitle('')
fig.tight_layout()
fig.savefig(os.path.join(out_dir, 'diamonds_price_by_cut.png'), dpi=300)
plt.close(fig)

print('图表已保存到:', out_dir)
脚本:05-diamonds-save-figures.py | 数据:diamonds.csv
fig.suptitle('') 是去掉 pandas 自动加的组标题,避免和 ax.set_title 重复。
第 3 步:midwest 分类对比。
import pandas as pd

midwest = pd.read_csv('data/05-eda-viz/midwest.csv')
state_pop = midwest.groupby('state')['poptotal'].sum().sort_values(ascending=False)

print('midwest shape:', midwest.shape)
print('各州总人口:')
print(state_pop.to_string())
print()
print('各州县数量:')
print(midwest['state'].value_counts().to_string())
脚本:06-midwest-summary.py | 数据:midwest.csv
实际输出:
midwest shape: (437, 28)
各州总人口:
state
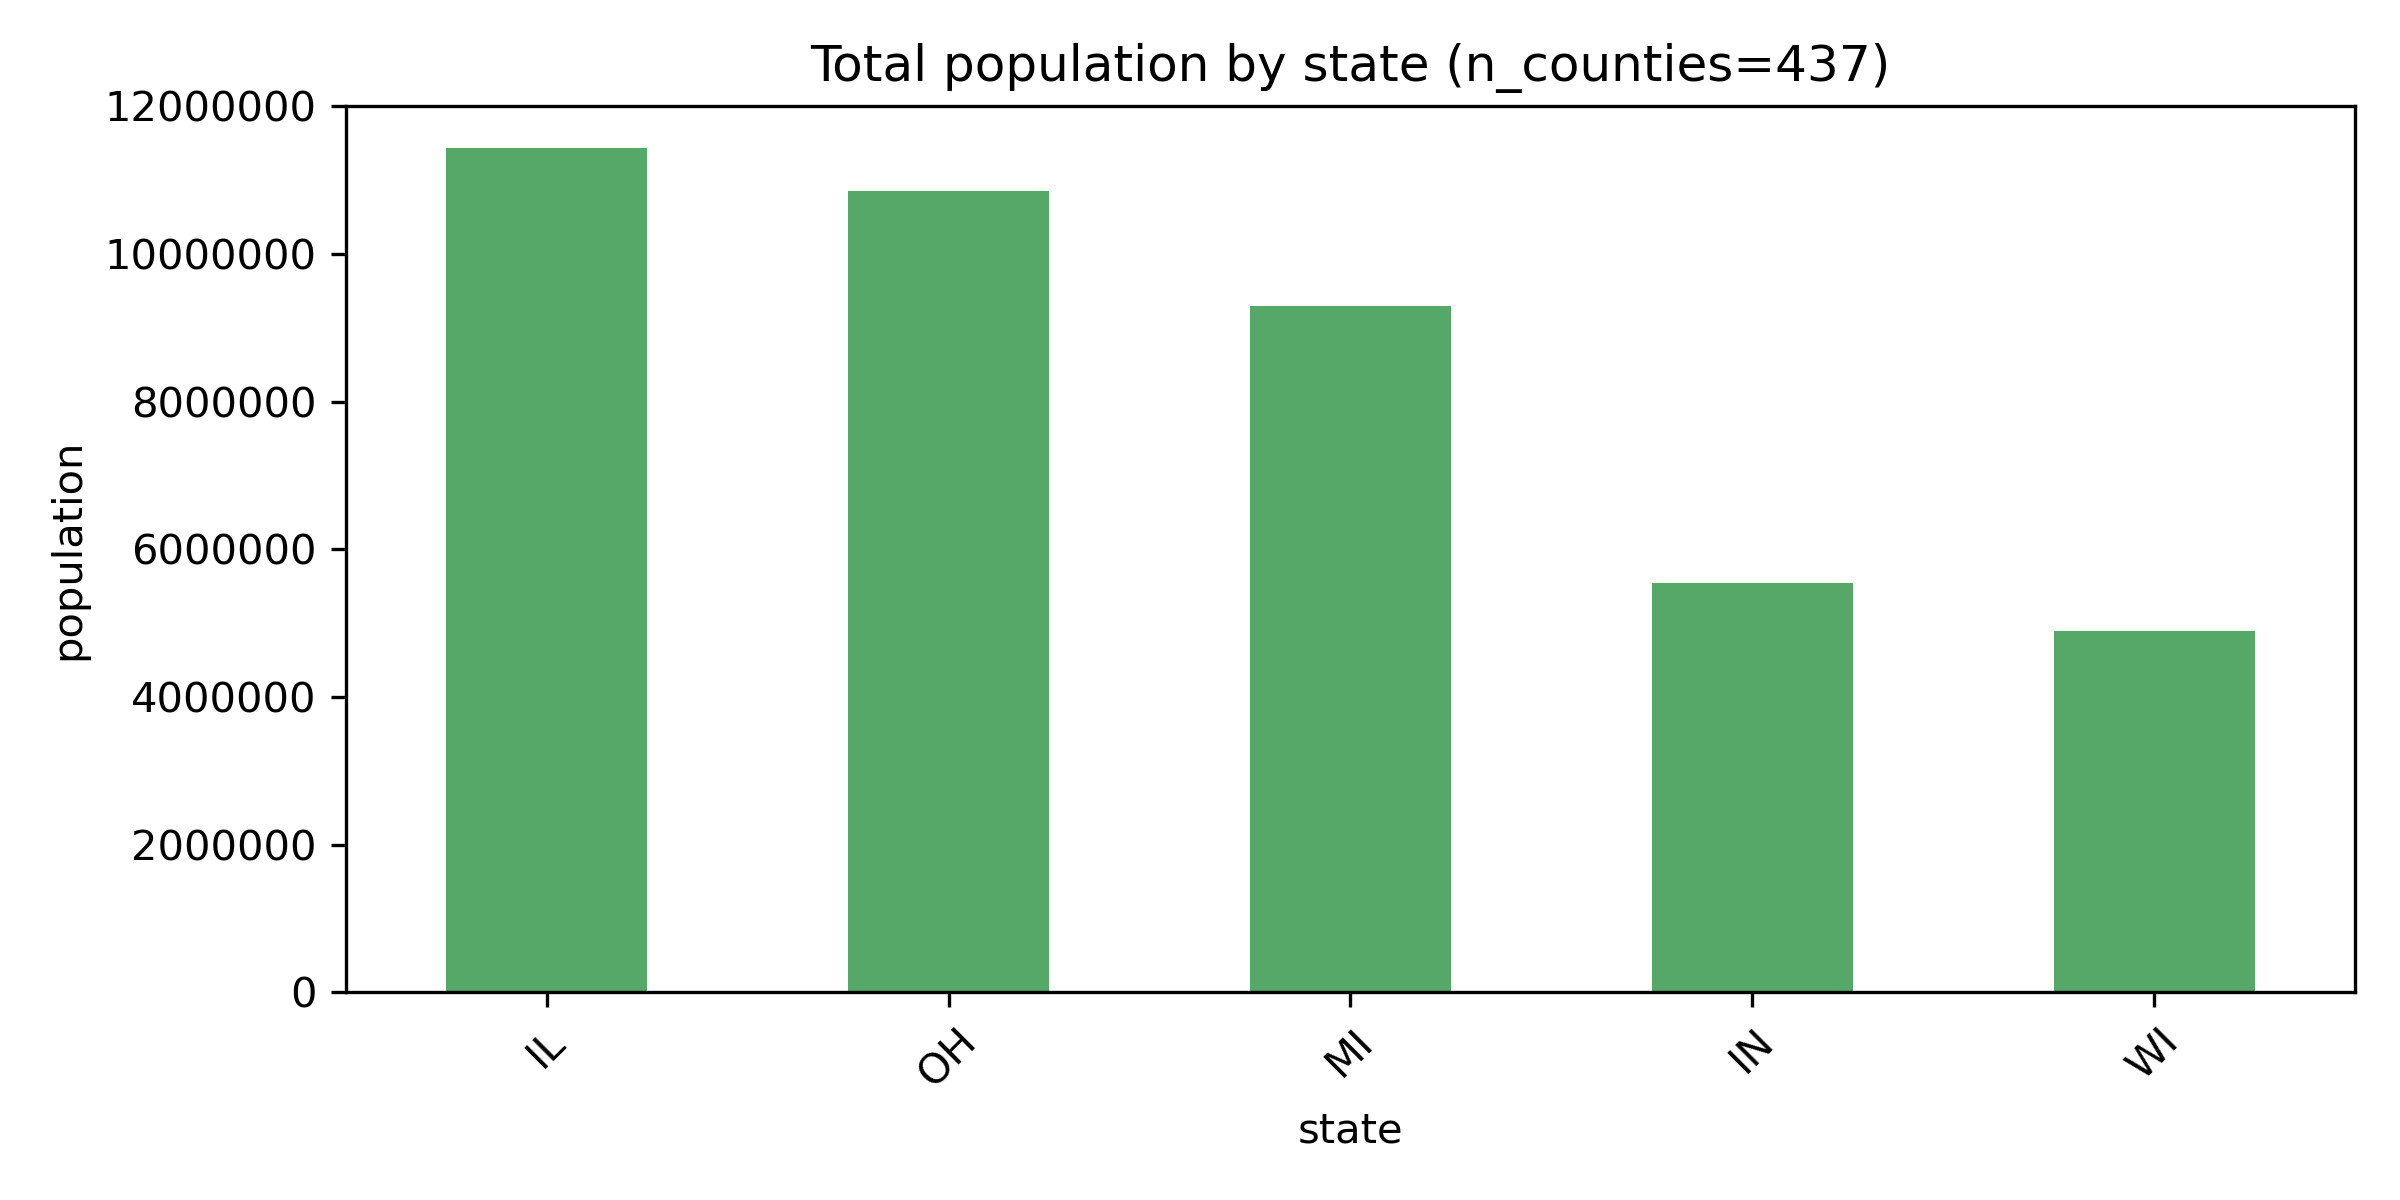
IL    11430602
OH    10847115
MI     9295297
IN     5544159
WI     4891769

各州县数量:
state
IL    102
IN     92
OH     88
MI     83
WI     72
import os
import matplotlib.pyplot as plt
import pandas as pd

midwest = pd.read_csv('data/05-eda-viz/midwest.csv')
state_pop = midwest.groupby('state')['poptotal'].sum().sort_values(ascending=False)
out_dir = 'projects/demo/04-viz'
os.makedirs(out_dir, exist_ok=True)

fig, ax = plt.subplots(figsize=(8, 4))
state_pop.plot.bar(ax=ax, color='#55a868')
ax.set_title(f'Total population by state (n_counties={len(midwest)})')
ax.set_xlabel('state')
ax.set_ylabel('population')
ax.ticklabel_format(style='plain', axis='y')
ax.set_xticklabels(ax.get_xticklabels(), rotation=45)
fig.tight_layout()
fig.savefig(os.path.join(out_dir, 'midwest_population.png'), dpi=300)
plt.close(fig)
脚本:07-midwest-save-figure.py | 数据:midwest.csv
读法:IL 总人口最多,为 11430602。但州之间的县数量不同,IL 有 102 个县,WI 有 72 个县。因此“总人口”和“平均每县人口”是两个不同的问题,不能混着读。
1.6 DSH vibe loop
第一次给 DSH 的提示词:
请先不要执行,给我 data/05-eda-viz/diamonds.csv 的可视化计划。
第一步只做 price 的直方图和按 cut 的箱线图,代码只用 pandas 和 matplotlib。
每张图必须有标题、轴标签、样本量,输出写入 projects/<姓名>/,不要改 data/。
先给我计划,再逐张图小步执行。
拿到计划后,先确认它“先打印 describe/groupby,再出图”,再让它跑第一步。看到图后追问:为什么 price 是右偏?Ideal 切工样本量最多,能不能只比较中位数?
1.7 第 1 节课验收
下课前至少完成:
- [ ] 能报出
diamonds.csv的shape (53940, 10)、price均值 3932.80、中位数 2401.00 - [ ] 会画直方图和箱线图,并说明箱体上下边是 Q1 和 Q3
- [ ] 会用
groupby('cut')['price'].agg(['count', 'mean', 'median'])比较切工 - [ ] 能报出
midwest.csv的shape (437, 28)、人口最多州 IL 总人口 11430602 - [ ] 两张图都写入
projects/<姓名>/,带标题、轴标签和样本量 - [ ] 完成一次 vibe loop:先计划、最小版本、运行、反馈、追问、验证
2. 第 2 节课 时间序列与趋势(45 分钟)
| 时间 | 环节 | 内容 |
|---|---|---|
| 8 分钟 | 演示 | 讲 pd.to_datetime、dt.date、按天聚合均值 |
| 30 分钟 | 练习 | 学生把每小时负荷聚合成日均负荷,画最近 120 天折线图 |
| 7 分钟 | 复盘 | 核对样本量:35064 行、36 个缺失、1462 天日均值 |
2.1 问题
energy_dataset.csv的time是字符串,怎么转成真正的日期时间?- 原始是每小时一条,怎么聚合成日均负荷?
- 日均负荷的趋势怎么画,为什么只画最近 120 天?
2.2 概念
pd.to_datetime(..., errors='coerce', utc=True)把字符串转成时间戳;无法解析的变NaT。.dt.date是时间戳的日期部分;按date分组就是“按天聚合”。- 原始粒度是小时,画整条序列会很挤;先
groupby('date').mean()降到天再画。 - 折线图适合看趋势;窗口选最近 120 天是“看近期变化”,不是“只保留 120 天”。
- 画时间序列前先排序,并统计聚合后的样本量,避免把缺失当真实值。
2.3 最小代码
import matplotlib.pyplot as plt
import pandas as pd

energy = pd.read_csv('data/05-eda-viz/energy_dataset.csv')
energy['time'] = pd.to_datetime(energy['time'], errors='coerce', utc=True)
energy['date'] = energy['time'].dt.date
daily = energy.groupby('date')['total load actual'].mean()

daily.plot.line(figsize=(8, 4))
plt.title('Average daily total load')
plt.xlabel('date')
plt.ylabel('total load actual')
plt.show()
脚本:08-energy-daily-line.py | 数据:energy_dataset.csv
2.4 自己试
- 读入
energy_dataset.csv,报告行数和time的 dtype。 - 用
pd.to_datetime(..., errors='coerce', utc=True)转time,统计解析失败的数量。 - 检查
total load actual的缺失数,回答为什么要在聚合前dropna。 - 用
groupby('date')['total load actual'].mean()算日均负荷,报告 1462 天。 - 分别画最近 30 天、120 天、365 天的折线图,比较趋势差异。
2.5 应用到数据
第 1 步:解析时间并聚合到天。
import pandas as pd

energy = pd.read_csv('data/05-eda-viz/energy_dataset.csv')
energy['time'] = pd.to_datetime(energy['time'], errors='coerce', utc=True)
energy['total load actual'] = pd.to_numeric(energy['total load actual'], errors='coerce')
energy = energy.dropna(subset=['time', 'total load actual']).sort_values('time')
energy['date'] = energy['time'].dt.date
daily = energy.groupby('date')['total load actual'].mean()

print('解析后行数:', len(energy))
print('时间范围:', energy['time'].min(), '到', energy['time'].max())
print('日均负荷样本量:', len(daily))
print('最近 5 天:')
print(daily.tail().round(2).to_string())
脚本:09-energy-parse-summary.py | 数据:energy_dataset.csv
实际输出:
解析后行数: 35028
时间范围: 2014-12-31 23:00:00+00:00 到 2018-12-31 22:00:00+00:00
日均负荷样本量: 1462
最近 5 天:
date
2018-12-27    28551.71
2018-12-28    28661.17
2018-12-29    26603.96
2018-12-30    25238.50
2018-12-31    25966.17
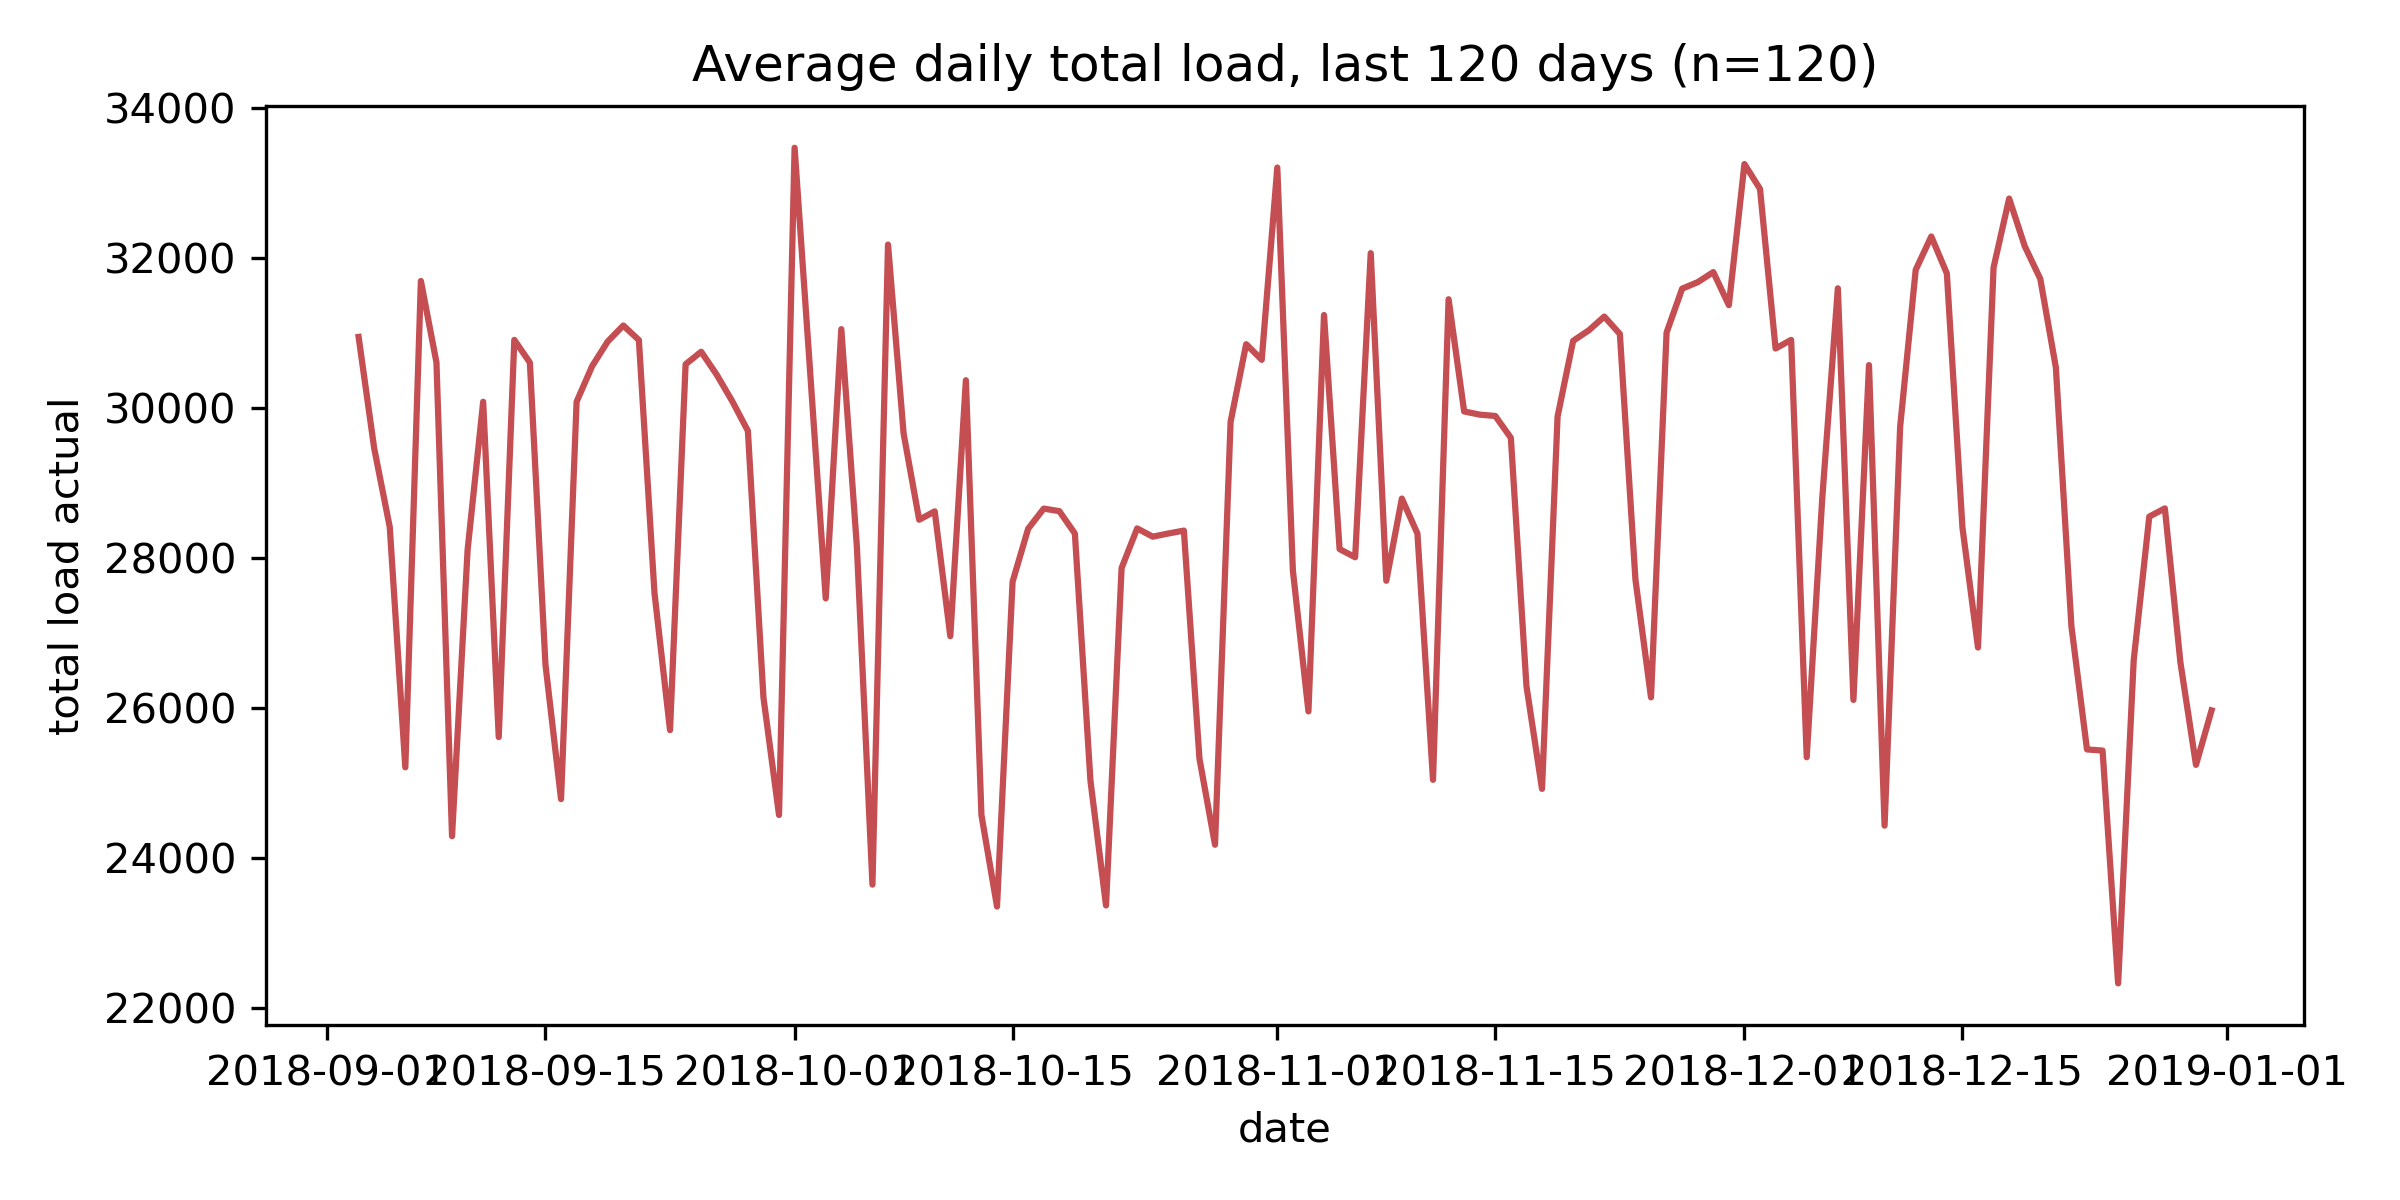
读法:原始 35064 行,total load actual 有 36 个缺失,去掉后剩 35028 行;时间跨度 2014-12-31 到 2018-12-31,聚合后 1462 天。最近几天日均负荷在 2.5 万到 2.9 万之间波动。
第 2 步:画最近 120 天折线图。
import os
import matplotlib.pyplot as plt
import pandas as pd

energy = pd.read_csv('data/05-eda-viz/energy_dataset.csv')
energy['time'] = pd.to_datetime(energy['time'], errors='coerce', utc=True)
energy['total load actual'] = pd.to_numeric(energy['total load actual'], errors='coerce')
energy = energy.dropna(subset=['time', 'total load actual']).sort_values('time')
energy['date'] = energy['time'].dt.date
daily = energy.groupby('date')['total load actual'].mean()

out_dir = 'projects/demo/04-viz'
os.makedirs(out_dir, exist_ok=True)

fig, ax = plt.subplots(figsize=(8, 4))
daily.tail(120).plot.line(ax=ax, color='#c44e52')
ax.set_title('Average daily total load, last 120 days (n=120)')
ax.set_xlabel('date')
ax.set_ylabel('total load actual')
fig.tight_layout()
fig.savefig(os.path.join(out_dir, 'energy_load.png'), dpi=300)
plt.close(fig)

print('图表已保存到:', out_dir)
脚本:10-energy-save-figure.py | 数据:energy_dataset.csv
daily.tail(120) 只取最后 120 天画图,daily 本身仍是完整的 1462 天,没有丢数据。
2.6 DSH vibe loop
请先不要执行,给我 data/05-eda-viz/energy_dataset.csv 的时间序列计划。
第一步只做:time 转日期时间、按 date 聚合日均负荷、画最近 120 天折线图。
只用 pandas 和 matplotlib,图要有标题、轴标签、样本量,写入 projects/<姓名>/。
先给计划,确认后再执行。
看到 DSH 的输出后,你要自己验证:解析后行数是不是 35028、日均负荷样本量是不是 1462、时间范围是不是 2014 年底到 2018 年底。
2.7 第 2 节课验收
下课前至少完成:
- [ ] 能报出原始 35064 行、
total load actual缺失 36、解析后 35028 行 - [ ] 会用
pd.to_datetime(..., errors='coerce', utc=True)转时间戳 - [ ] 会用
.dt.date和groupby('date').mean()聚合成 1462 天日均负荷 - [ ] 能画出最近 120 天折线图,带标题、轴标签和样本量
- [ ] 能说明“先排序、先 dropna、再聚合”的顺序原因
- [ ] 完成一次 vibe loop:先计划、最小版本、运行、反馈、追问、验证
3. 第 3 节课 pandas 集成绘图与组合图(45 分钟)
| 时间 | 环节 | 内容 |
|---|---|---|
| 8 分钟 | 演示 | 讲 df.plot()、groupby(...).plot()、plt.subplots() 三种写法 |
| 30 分钟 | 练习 | 学生画预期寿命年度趋势、按 Status 分组趋势、一张图两个子图 |
| 7 分钟 | 复盘 | 核对样本量:16 个年份、Developed 15 / Developing 16、2015 无 Developed |
3.1 问题
- 直接用 pandas 怎么画折线图,
df.plot()的kind有哪些? groupby(...).plot()和先聚合再plot()有什么区别?- 一张图放多个子图用
plt.subplots()怎么做?
3.2 概念
df.plot()等价于df.plot(kind='line');换kind='bar'、'hist'、'box'就能换图型。groupby(...).plot()是 pandas 的快捷写法,但“每组按原始行索引画”容易画出错误 x 轴;趋势图要先.mean()或.unstack()再plot()。groupby([...]).mean().unstack()把长表转成宽表,每个分组变成一列,plot()后每条线就是一列。plt.subplots(nrows, ncols)返回fig和axes数组,每个ax独立设置标题、轴标签、图例。- 面板不完整时,某些年份分组是
NaN;图里要保留这个“缺口”,不要填 0 假装完整。
3.3 最小代码
先用 df.plot() 画年度均值:
import matplotlib.pyplot as plt
import pandas as pd

life = pd.read_csv('data/04-cleaning/Life_Expectancy_Data.csv')
life.columns = [c.strip() for c in life.columns]

year_mean = life.groupby('Year')['Life expectancy'].mean()
year_mean.plot()
plt.show()
脚本:11-life-year-line.py | 数据:Life_Expectancy_Data.csv
再用 groupby(...).unstack().plot() 画分组趋势:
import matplotlib.pyplot as plt
import pandas as pd

life = pd.read_csv('data/04-cleaning/Life_Expectancy_Data.csv')
life.columns = [c.strip() for c in life.columns]

life.groupby(['Year', 'Status'])['Life expectancy'].mean().unstack().plot()
plt.show()
脚本:12-life-status-lines.py | 数据:Life_Expectancy_Data.csv
最后用 plt.subplots() 把两张图放进一个画布:
import matplotlib.pyplot as plt
import pandas as pd

life = pd.read_csv('data/04-cleaning/Life_Expectancy_Data.csv')
life.columns = [c.strip() for c in life.columns]
year_mean = life.groupby('Year')['Life expectancy'].mean()
status_year = life.groupby(['Year', 'Status'])['Life expectancy'].mean().unstack()

fig, axes = plt.subplots(1, 2, figsize=(10, 4))
year_mean.plot(ax=axes[0])
status_year.plot(ax=axes[1])
plt.show()
脚本:13-life-subplots.py | 数据:Life_Expectancy_Data.csv
3.4 自己试
- 读入
Life_Expectancy_Data.csv,把列名统一成去除首尾空格。 - 用
life.groupby('Year')['Life expectancy'].mean()算年度均值,再用kind='bar'画成柱状图,比较和折线图的信息差异。 - 用
groupby(['Year', 'Status']).mean().unstack().plot()画两条线,说明legend的作用。 - 用
plt.subplots(1, 2)把年度均值和 Status 分组趋势放同一张图。 - 解释为什么 2015 年 Developed 是 NaN,并把这个缺口保留在图里。
3.5 应用到数据
第 1 步:先聚合,打印样本量。
import pandas as pd

life = pd.read_csv('data/04-cleaning/Life_Expectancy_Data.csv')
life.columns = [c.strip() for c in life.columns]

year_mean = life.groupby('Year')['Life expectancy'].mean()

print('年份趋势样本量:', len(year_mean))
print(year_mean.round(2).tail().to_string())
print()

status_year = life.groupby(['Year', 'Status'])['Life expectancy'].mean().unstack()
print('Status x Year 各分组样本量:')
print(status_year.notna().sum().to_string())
print()
print(status_year.round(2).tail().to_string())
脚本:14-life-summary.py | 数据:Life_Expectancy_Data.csv
实际输出:
年份趋势样本量: 16
Year
2011    69.86
2012    70.24
2013    70.39
2014    70.52
2015    71.40

Status x Year 各分组样本量:
Status
Developed     15
Developing    16

Status  Developed  Developing
Year
2011        80.72       68.00
2012        80.27       68.51
2013        80.30       68.69
2014        81.03       68.74
2015          NaN       71.40
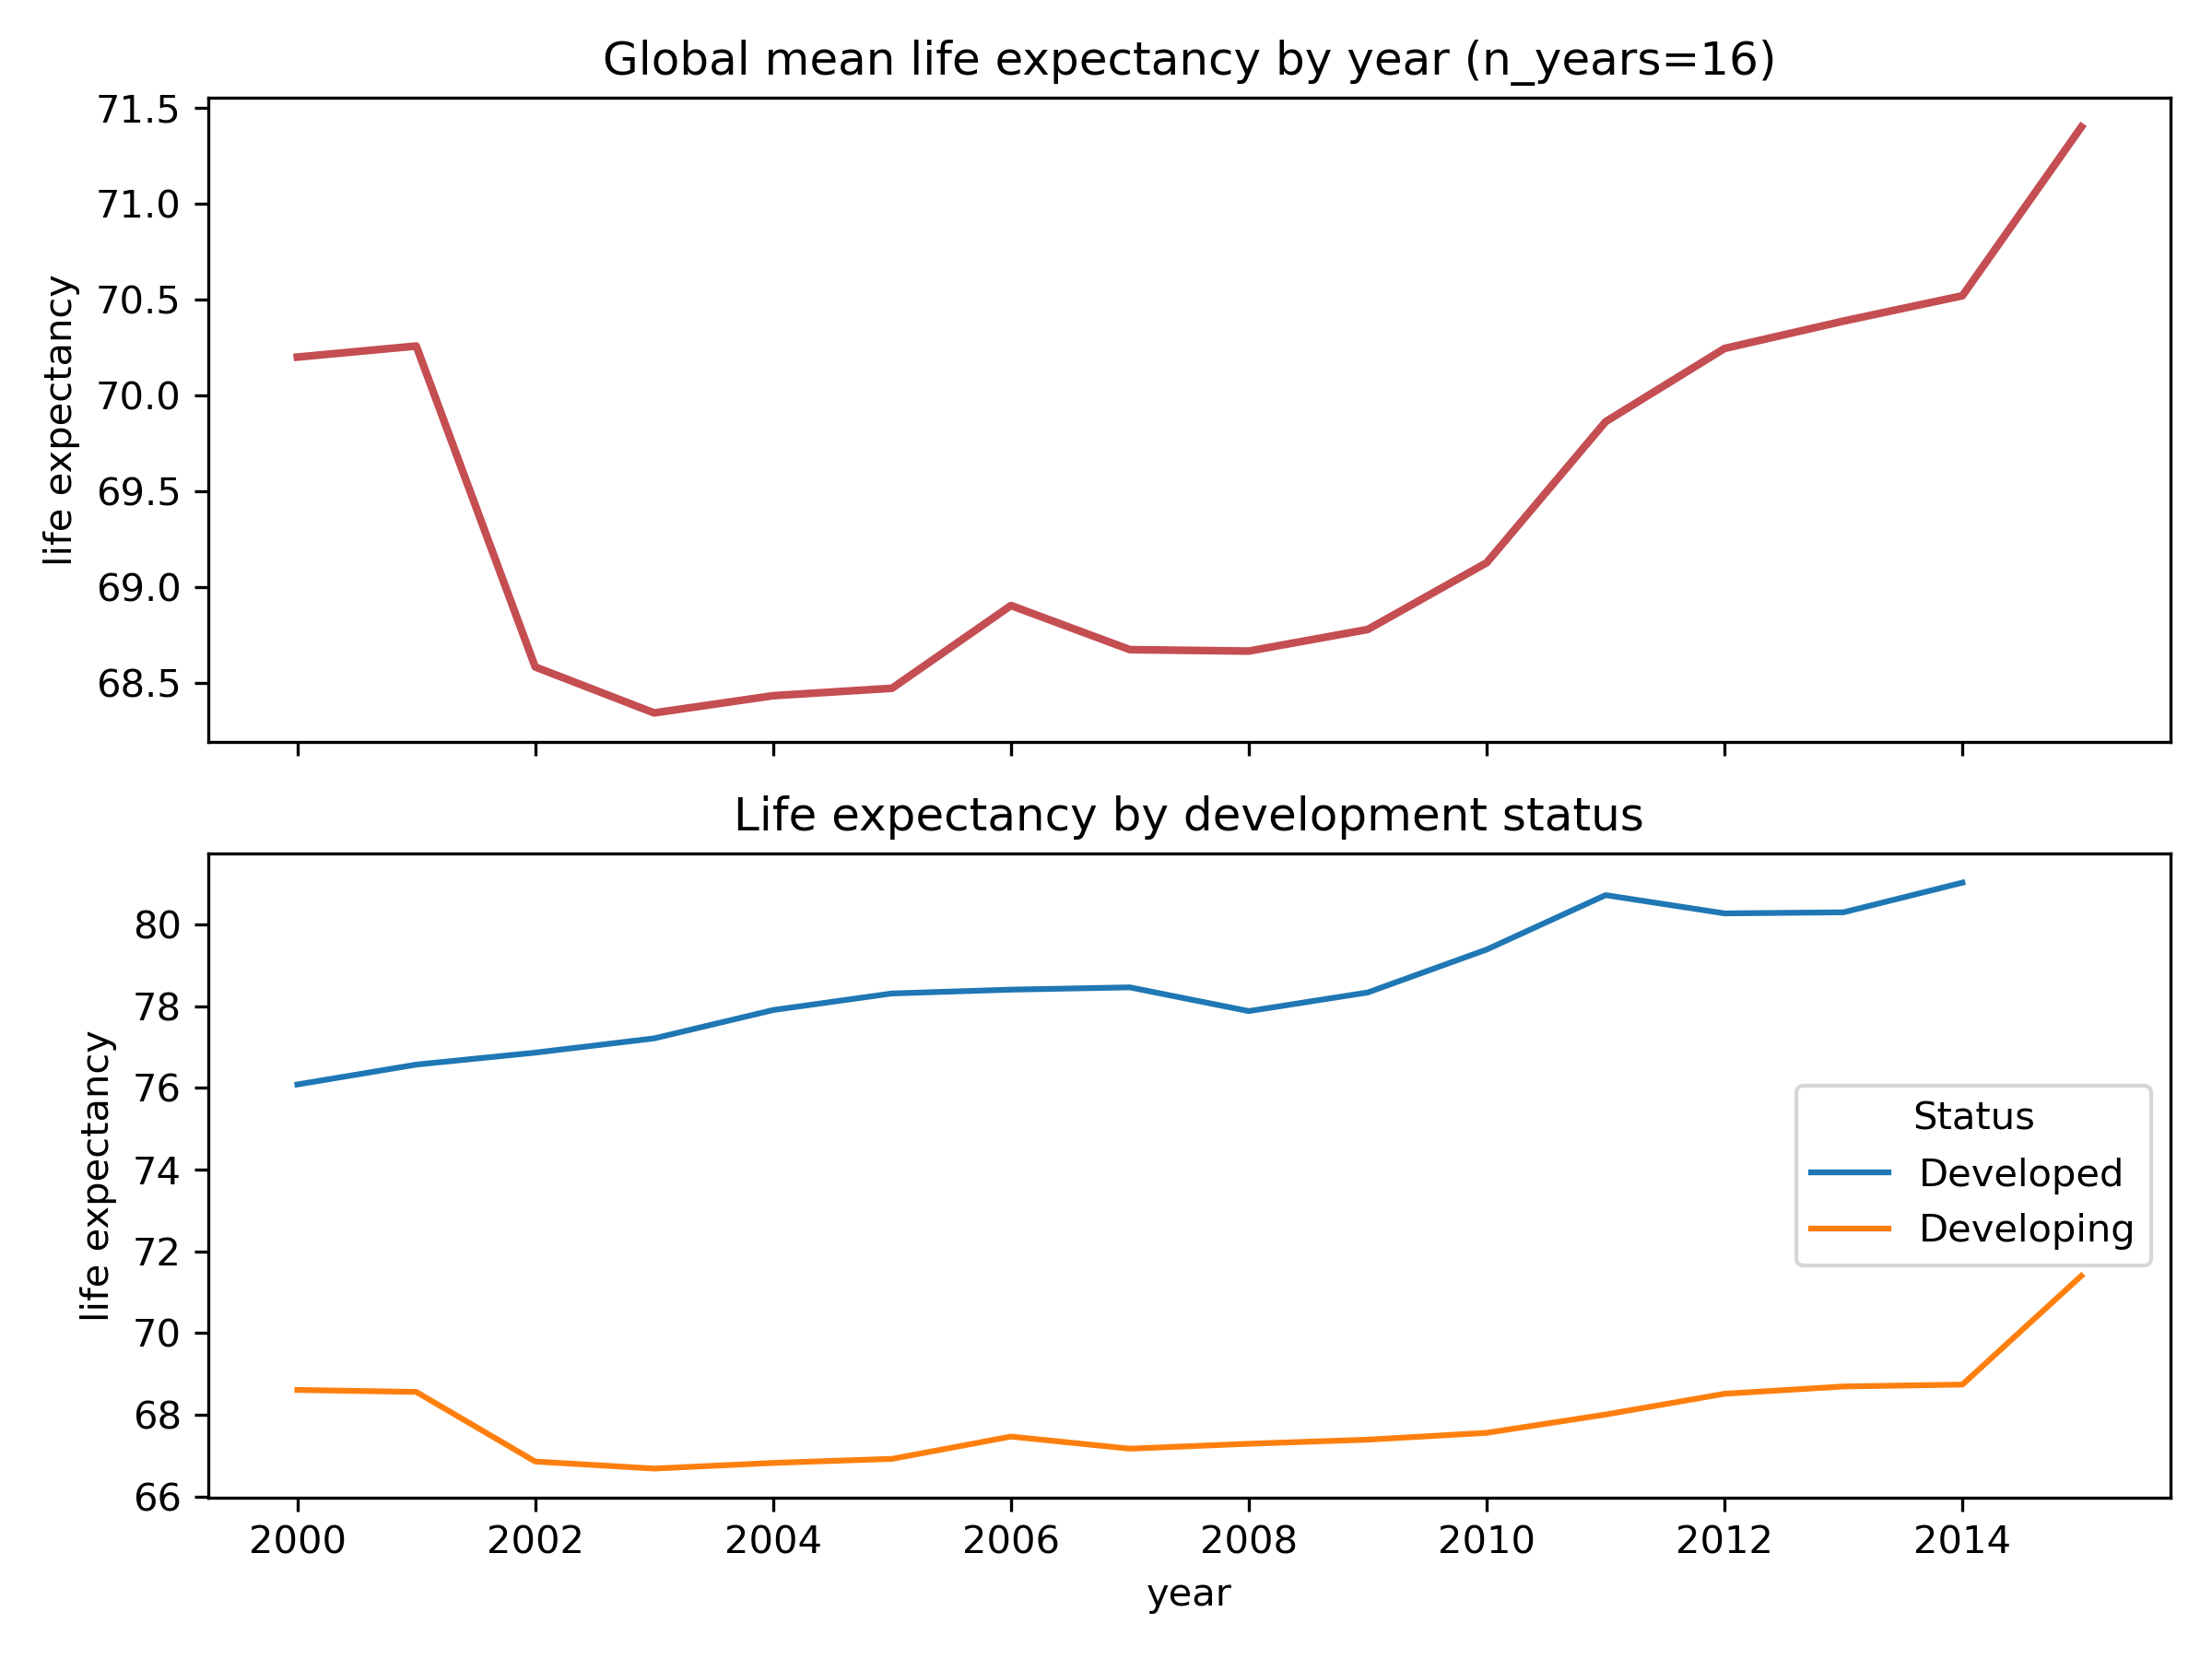
读法:16 个年份里,Developed 只有 15 年数据,Developing 有 16 年;2015 年只有 Developing 的均值 71.40,没有 Developed,所以宽表里 2015 的 Developed 是 NaN。这个缺口是真实面板结构,不能填 0。
第 2 步:df.plot() 和 plt.subplots() 组合图。
import os
import matplotlib.pyplot as plt
import pandas as pd

life = pd.read_csv('data/04-cleaning/Life_Expectancy_Data.csv')
life.columns = [c.strip() for c in life.columns]
year_mean = life.groupby('Year')['Life expectancy'].mean()
status_year = life.groupby(['Year', 'Status'])['Life expectancy'].mean().unstack()

out_dir = 'projects/demo/04-viz'
os.makedirs(out_dir, exist_ok=True)

fig, axes = plt.subplots(nrows=2, ncols=1, figsize=(8, 6), sharex=True)

year_mean.plot.line(ax=axes[0], color='#c44e52', linewidth=2)
axes[0].set_title(f'Global mean life expectancy by year (n_years={len(year_mean)})')
axes[0].set_ylabel('life expectancy')

status_year.plot.line(ax=axes[1])
axes[1].set_title('Life expectancy by development status')
axes[1].set_xlabel('year')
axes[1].set_ylabel('life expectancy')
axes[1].legend(title='Status')

fig.tight_layout()
fig.savefig(os.path.join(out_dir, 'life_expectancy_combined.png'), dpi=300)
plt.close(fig)

print('图表已保存到:', out_dir)
脚本:15-life-save-combined.py | 数据:Life_Expectancy_Data.csv
sharex=True 让两个子图共用 x 轴刻度;legend(title='Status') 给第二张图加图例,明确两条线分别对应 Developed 和 Developing。
3.6 DSH vibe loop
请先不要执行,给我 data/04-cleaning/Life_Expectancy_Data.csv 的组合图计划。
重点演示 df.plot()、groupby(...).plot()、plt.subplots() 三种写法。
只用 pandas 和 matplotlib,图要有标题、轴标签、图例或样本量。
先给计划,确认后再执行,写入 projects/<姓名>/。
拿到 DSH 的代码后,你要自己核对:它是不是先 groupby(...).mean() 再 plot();unstack() 后 Developed 是不是 15、Developing 是不是 16;2015 年的 NaN 有没有被偷偷填掉。
3.7 第 3 节课验收
下课前至少完成:
- [ ] 能用
df.plot()画折线,并说出kind='bar'、'hist'、'box'的差别 - [ ] 能解释
groupby(...).plot()要先.mean()或.unstack()再画 - [ ] 能用
plt.subplots()把两张图放进一个画布,并分别设标题和轴标签 - [ ] 能报出 16 个年份、Developed 15 / Developing 16、2015 年 Developed 为 NaN
- [ ] 组合图写入
projects/<姓名>/,带标题、轴标签、图例或样本量 - [ ] 完成一次 vibe loop:先计划、最小版本、运行、反馈、追问、验证
4. 本周验证清单
- [ ] 能说出本周流程:判断变量类型、选图、聚合、出图、加标签、读图写结论
- [ ]
diamonds.csv:shape (53940, 10)、price均值 3932.80、中位数 2401.00、cut 计数 Ideal 21551 - [ ]
midwest.csv:shape (437, 28)、人口最多州 IL 总人口 11430602、县数量 IL 102 / WI 72 - [ ]
energy_dataset.csv:原始 35064 行、缺失 36、解析后 35028 行、日均样本 1462 天 - [ ]
Life_Expectancy_Data.csv:16 个年份、Developed 15 / Developing 16、2015 年 Developed 为 NaN - [ ] 所有原始文件未被修改;6 张图写入
projects/<姓名>/ - [ ] 每张图都有标题、轴标签、图例或样本量
- [ ] 每次 DSH 操作都走完 vibe loop,不盲信它直接生成的图
5. 常见错误与坑
| 现象 | 原因 | 处理 |
|---|---|---|
| 图上没有标题和轴标签 | 只画了图,没写 set_title / set_xlabel | 每张图补齐标题、轴标签、图例或样本量 |
直方图 bins 过大或过小 | 没有看区间宽度对形状的影响 | 试 10 / 50 / 100,选能看清主峰的宽度 |
把原始行直接 groupby().plot.bar() | 分类变量有重复取值,没先聚合 | 先 groupby().sum() 或 .mean() 再画 |
| 柱状图 y 轴是科学计数法 | 数值过大,默认格式难看 | ax.ticklabel_format(style='plain', axis='y') |
time 还是 object 就画图 | 没转日期时间,x 轴不是时间 | 先 pd.to_datetime(..., errors='coerce') |
| 每小时数据直接画整条线 | 点太密,趋势被噪声盖住 | 先按 date 聚合成天再画 |
| 时间序列没有排序 | 数据乱序,折线来回穿 | sort_values('time') 再画 |
| 聚合前没 dropna | 缺失被当成 0 或拖低均值 | dropna(subset=[...]) 后报告前后行数 |
groupby(...).plot() 直接画原始行 | x 轴变成原始行索引,不是年份 | 先 .mean() 或 .unstack() 再 plot() |
| 面板缺口被填 0 | 某些年份没有数据,填 0 假装完整 | 保留 NaN,写结论时说明样本量 |
| 组合图所有子图叠在一起 | 没把每个 ax 分开设标题和图例 | 用 axes[i] 分别 set_title 和 legend |
| 中文字体变方框 | 字体缺失 | 用英文标签,或先配置中文字体 |
6. 作业
- 新建
projects/<姓名>/viz_pipeline.py,用 pandas 和 matplotlib 生成 6 张图:diamonds_price_hist.png、diamonds_price_by_cut.png:价格分布与切工对比;midwest_population.png:各州总人口柱状图;energy_load.png:日均负荷最近 120 天折线图;life_expectancy_combined.png:预期寿命年度趋势与 Status 分组趋势组合图。
- 每张图都要有标题、轴标签、图例或样本量;脚本里先打印
describe()或groupby()的样本量,再出图。 - 把 6 张图对应的“问题 → 变量类型 → 图型 → 样本量 → 结论”整理成
projects/<姓名>/viz_report.md。 - 让 DSH 先审查
viz_pipeline.py的计划再小步执行,明确禁止删除或覆盖data/,并逐张图说明标题、轴标签、图例或样本量。 - 用一句话回答:为什么“2015 年 Developed 为 NaN”和“把每小时数据画成整条线”都不能靠填 0 或直接画解决?
7. 参考写法
- pydata-book:Wes McKinney 的《Python for Data Analysis》配套源码,pandas 作者写的权威入门。
- PythonDataScienceHandbook:Jake VanderPlas 的《Python 数据科学手册》,matplotlib 章节讲得清楚。
- pandas-videos:Data School 的 pandas 视频教程,按主题拆成短片段,适合跟着练。
- pandas:pandas 官方仓库,
df.plot()和可视化文档的最终出处。
评分要点
| 项目 | 要求 |
|---|---|
| 变量判断 | 能说清每个变量是数值型还是分类型,并解释为什么选这种图 |
| 分布 | 直方图、箱线图带标题、轴标签、样本量,能读出右偏和五数概括 |
| 分类对比 | 先 groupby().sum() 再柱状图,结论带各州人口和县数量 |
| 时间序列 | pd.to_datetime、按天聚合、排序、dropna,报告 35028 行与 1462 天 |
| 集成绘图 | 会用 df.plot()、groupby().unstack().plot()、plt.subplots() |
| 组合图 | 两个子图分别设标题、轴标签、图例,保留 2015 年 NaN 缺口 |
| 图质量 | 6 张图写入 projects/<姓名>/,每张都有标题、轴标签、图例或样本量 |
| DSH 协作 | 走完 vibe loop,不盲信 Agent,能解释一个关键作图决策 |